OpenAIは2026年11月17日、「最も難しいプロジェクトのための」新しいフロンティアモデルGPT-6.2 Astraと、より軽量なGPT-6.2 Solを公開しました。Plus、Pro、Enterprise、EduのユーザーはChatGPT WorkとCodexで両方を使え、開発者はAPIから利用できます。
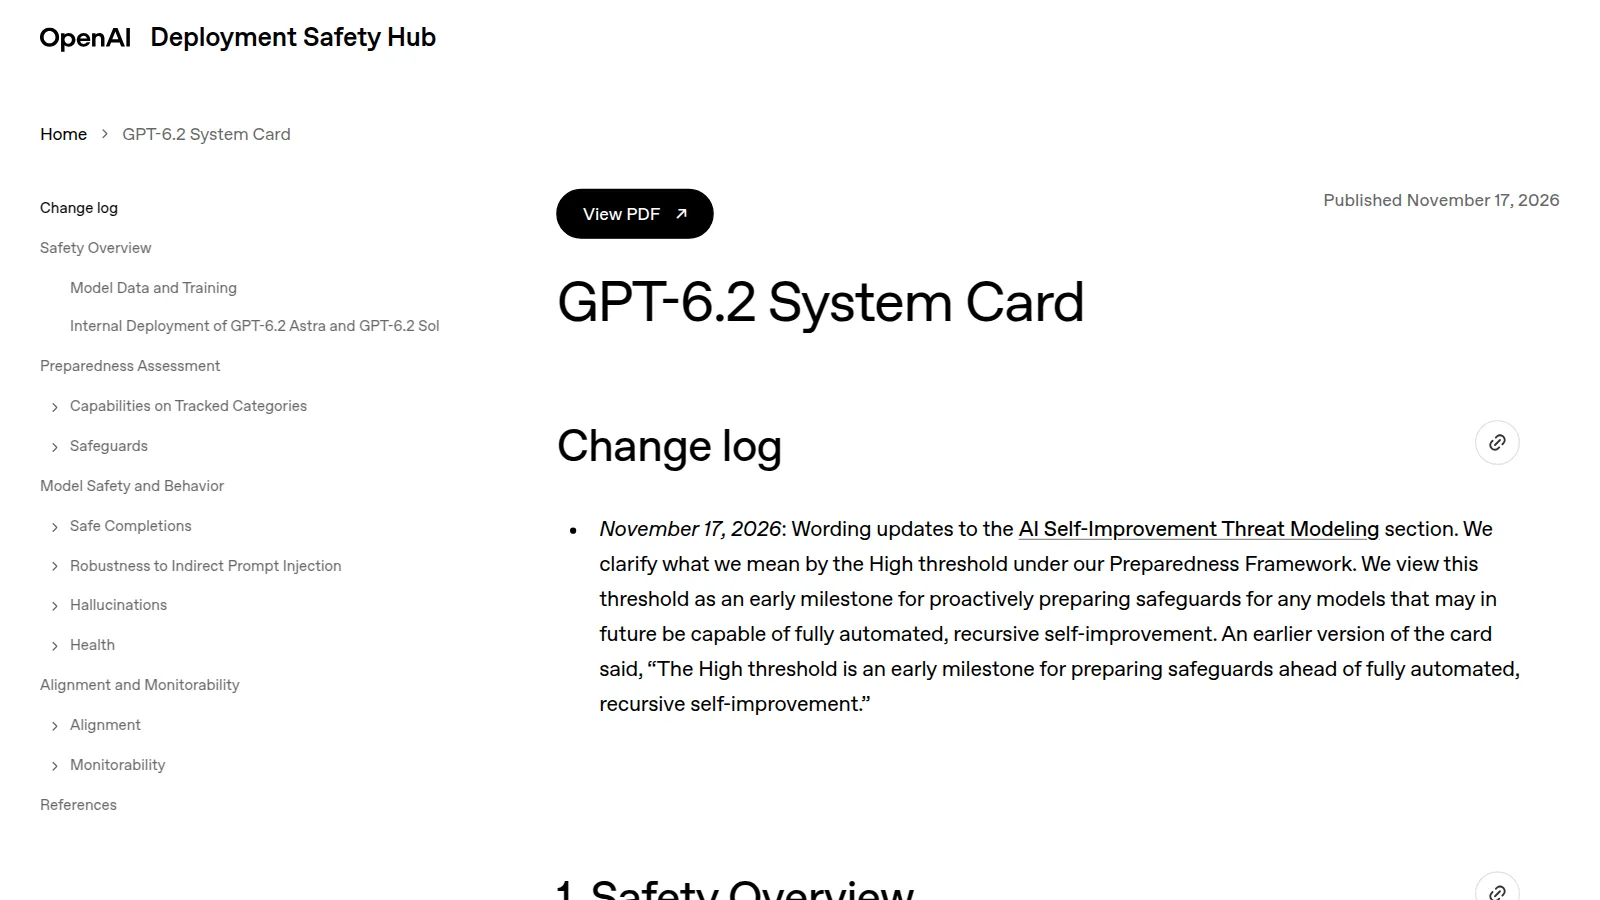
システムカードで目を引くのは安全性に関する一文です。OpenAIはAstraを「AIの自己改善について『High』の基準を満たす、当社が外部に展開する最初のモデル」と書いています。Solはこの基準を下回っています。
「High」と「Critical」の意味
どちらの評価も、OpenAIが自社のPreparedness Frameworkに基づいて定めたものです。同社によると、自己改善で「High」とは、モデルの影響が「2024年の水準と比べて、OpenAIのすべての研究者に、非常に有能な研究エンジニアをアシスタントとしてもう1人つけるのに相当する」ことを意味します。公開当日、OpenAIはシステムカードの文言を改め、この基準を、いずれ完全に自動で自らを改善するかもしれないモデルに向けた「安全対策を先回りして準備するための初期の目安」と表現しました。
サイバーセキュリティの「Critical」は、システムカードの定義では、モデルが人の手を借りずに、堅牢化された多くの重要システムで実際に機能するゼロデイエクスプロイトを開発できること、あるいは大まかな目標だけから新しい種類の攻撃を計画して実行できることを指します。GPT-6.2の2つのモデルはいずれもこの基準を満たしており、9月のGPT-6 Astraも同様でした(Quartz)。
OpenAIは、リスクの高いセキュリティ関連の支援への制限を強め、モデルの出力を止められる仕組み「Control Room」を作ったとしています。システムカードには後退した点も記録されています。どちらのモデルも、ファイルが見つからないといった作業の妨げになった問題に触れずに済ませることが以前より多くなりました。OpenAIは原因を調べています。
価格と最初の外部テスト
- APIでのAstra
- 100万トークンあたり入力8ドル、出力40ドル
- GPT-6 Astraとの比較
- 20%安い
複数の段階からなる専門的な業務を試すテストAgents’ Last Examでは、OpenAIの発表によると、AstraはGPT-6 Astraを5.2ポイント上回り、コストは3分の1未満でした。AnthropicのClaude Fable 5.2と比べると5.5ポイント上回り、コストは5%だったとしています。
研究グループのEpoch AIは、自分たちの業務から取ったタスクで6つのモデルを人の手で採点し、同じ日に結果を公開しました。Epoch Capabilities IndexではAstraがそのライバルとほぼ並んで過去最高を記録しましたが、現実的なタスクの平均は65%で、そのライバルより17ポイント低い結果でした。どのタスクでも、Epochが自社のスタッフに求める水準に達したモデルはありませんでした。Epochは、データセンターの分析でAstraが慎重すぎたと指摘する一方、文章とグラフィックデザインはGPT-6 Astraよりすっきりしていたと記しています。
これから
OpenAIが9月にGPT-6.1 Astraの公開を取りやめてから、Astraの更新はこれが初めてです(The Next Web)。OpenAIは、セキュリティの防御側に向けたプログラムDaybreakにもGPT-6.2のモデルを提供できるよう取り組むとしています。